Bối cảnh và vấn đề
Trong môi trường production, các ứng dụng dựa trên mô hình ngôn ngữ lớn (LLM) không luôn nhận được những câu hỏi hoàn toàn mới. Ví dụ, một trợ lý hỗ trợ khách hàng có thể gặp ba cách diễn đạt khác nhau nhưng cùng một nội dung cốt lõi:
- "Tôi có được hoàn tiền sau khi mua gói tháng không?"
- "Gói đăng ký theo tháng có được hoàn tiền không?"
- "Tôi có thể hủy gói và lấy lại tiền không?"
Mặc dù câu hỏi được phrasing khác nhau, câu trả lời thực tế vẫn giống nhau. Tuy nhiên, các hệ thống LLM thường xử lý mỗi yêu cầu như một request mới, lắp ráp lại prompt, gửi tới model và tạo ra câu trả lời dù đã từng được tạo trước đó. Điều này dẫn đến tiêu tốn không cần thiết các token đầu vào, token đầu ra và thời gian decode.
Phân tích chi tiết
Prefix caching
- Prefix caching giúp giảm một phần các lệnh gọi lặp lại khi các request bắt đầu bằng cùng một system prompt hoặc context.
- Model có thể tái sử dụng các trạng thái KV đã được tính toán sẵn cho phần tiền tố (prefix) chung, nhưng các token mới vẫn phải được xử lý và toàn bộ câu trả lời vẫn phải được decode.
Cache toàn bộ câu trả lời
- Để giải quyết vấn đề này, thay vì chỉ cache phần tính toán bên trong model, ứng dụng có thể cache luôn câu trả lời đã được tạo ra ở bên ngoài model.
- Khi một câu hỏi mới xuất hiện, hệ thống sẽ embedding câu hỏi và so sánh với các câu hỏi đã trả lời trước. Nếu tìm thấy một kết quả trùng khớp đủ gần, hệ thống sẽ trả về câu trả lời đã lưu sẵn mà không cần gọi lại LLM.
- Một lượt "trúng cache" (cache hit) sẽ loại bỏ hoàn toàn input token, output token, và thời gian decode gắn liền với một lượt gọi LLM khác.
Redis LangCache
- Redis đã triển khai cơ chế này dưới dạng dịch vụ quản lý mang tên Redis LangCache.
- Dịch vụ tạo embedding, tìm kiếm trong các câu trả lời trước, và trả về câu trả lời khớp trước khi một lệnh gọi model khác diễn ra.
- Redis cũng xử lý luôn phạm vi truy cập (access scope), bộ lọc tùy chỉnh (custom filtering), kiểm soát TTL và eviction (loại bỏ cache), cùng khả năng giám sát cache thông qua Redis Cloud.
Thực nghiệm
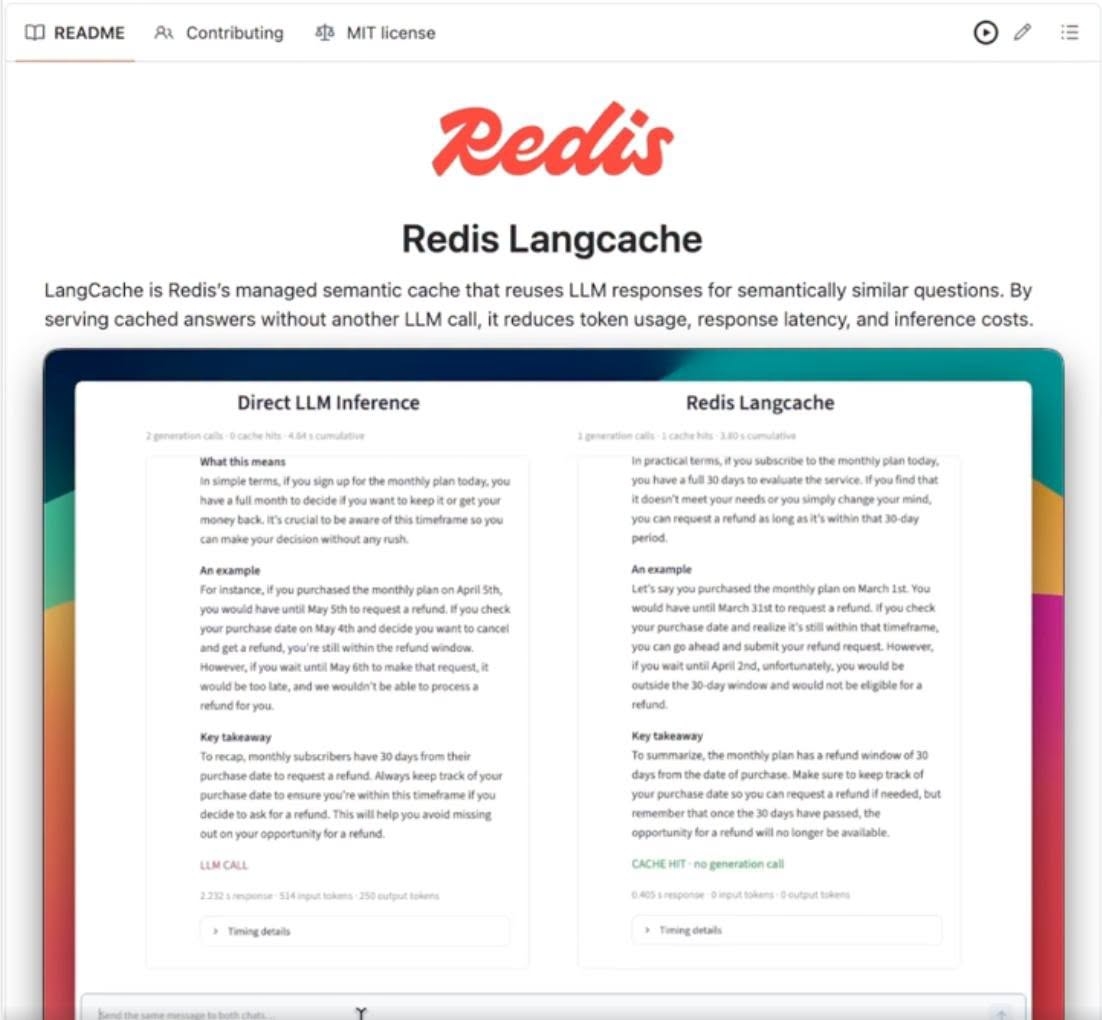
- Với câu hỏi được diễn đạt lại (paraphrase) trong lần thử, gọi inference trực tiếp mất 2.232 giây và tiêu tốn 514 input token cộng 250 output token.
- Redis trả về câu trả lời đã lưu chỉ trong 0.37 giây, không tiêu tốn token nào từ LLM, nhanh hơn khoảng 6 lần trong trường hợp này.
- Redis báo cáo mức tiết kiệm chi phí API lên tới 90% và phản hồi trúng cache nhanh hơn tới 15 lần, tùy thuộc vào mức độ lặp lại an toàn trong workload.
Tác động và ý nghĩa thực tiễn
- Giảm chi phí vận hành: Tiết kiệm tới 90% chi phí API LLM, giúp các doanh nghiệp nhỏ và vừa có thể triển khai AI mà không lo về ngân sách.
- Tăng tốc độ phản hồi: Phản hồi nhanh hơn tới 15 lần cải thiện trải nghiệm người dùng, đặc biệt trong các hệ thống hỗ trợ khách hàng thời gian thực.
- Độ tin cậy cao: Việc thiết lập ngưỡng tương đồng (similarity threshold) được tinh chỉnh kỹ, chính sách hết hạn (expiration policy), cơ chế cách ly dữ liệu (data isolation) và giám sát các trường hợp khớp sai giúp đảm bảo câu trả lời không gây nhầm lẫn hay vi phạm quy định dữ liệu.
- Tối ưu hoá tài nguyên: Giảm tải cho mô hình LLM, cho phép tái sử dụng tài nguyên tính toán cho các yêu cầu mới.
Gợi ý cho người học / phụ huynh / giáo viên
- Người học: Khi sử dụng công cụ AI để tra cứu kiến thức, hãy chú ý tới các câu hỏi lặp lại; nếu công cụ hỗ trợ cache, bạn sẽ nhận được câu trả lời nhanh hơn và không tốn token.
- Phụ huynh: Khi lựa chọn phần mềm hỗ trợ học tập cho con, ưu tiên các giải pháp tích hợp cơ chế cache như Redis LangCache để giảm chi phí và tăng tốc độ phản hồi.
- Giáo viên: Khi thiết kế chatbot hỗ trợ học sinh, hãy xác định rõ các câu hỏi thường gặp, thiết lập ngưỡng tương đồng phù hợp và cấu hình chính sách hết hạn để đảm bảo câu trả lời luôn cập nhật và an toàn.
- Tất cả: Đánh giá mức độ lặp lại trong workload của mình; nếu tỷ lệ câu hỏi lặp cao, đầu tư vào cơ chế cache sẽ mang lại lợi ích đáng kể.
Kết luận
Áp dụng cơ chế cache Redis trong các ứng dụng LLM không chỉ giảm chi phí tới 90% mà còn tăng tốc độ phản hồi lên tới 15 lần. Để đạt được hiệu quả tối đa, cần xác định những câu hỏi có thể chia sẻ chung một câu trả lời, thiết lập ngưỡng tương đồng, chính sách hết hạn, cơ chế cách ly dữ liệu và giám sát chặt chẽ. Khi được triển khai đúng cách, Redis LangCache sẽ là công cụ mạnh mẽ giúp các doanh nghiệp và nhà giáo dục khai thác tiềm năng của AI một cách hiệu quả và bền vững.
K?t lu?n
cơ chế cache Redis c� gi� tr? nh?t khi ngu?i d?c hi?u du?c � nghia h?c t?p, d? ki?n quan tr?ng v� bu?c t�m hi?u ti?p theo. M?t b�i vi?t xBook n�n gi�p tri th?c tr? n�n r� r�ng, d�ng tin v� c� th? d�ng du?c trong h�nh tr�nh h?c t?p.